Zuletzt aktualisiert: 18. September 2026 · Version: 1.2
Redaktionshinweis: Dieser Artikel wurde mit KI-Unterstützung recherchiert und überarbeitet sowie menschlich redaktionell geprüft. Produktangaben und Leistungswerte stammen überwiegend von Alibaba Cloud und dem Qwen-Team; unabhängige Vergleichsdaten zur Nutzung außerhalb der Anbieterumgebung liegen zum Veröffentlichungszeitpunkt nur begrenzt vor. Funktionen können je nach Tarif, Region, Client und Freigaben des Unternehmens abweichen.
In 30 Sekunden
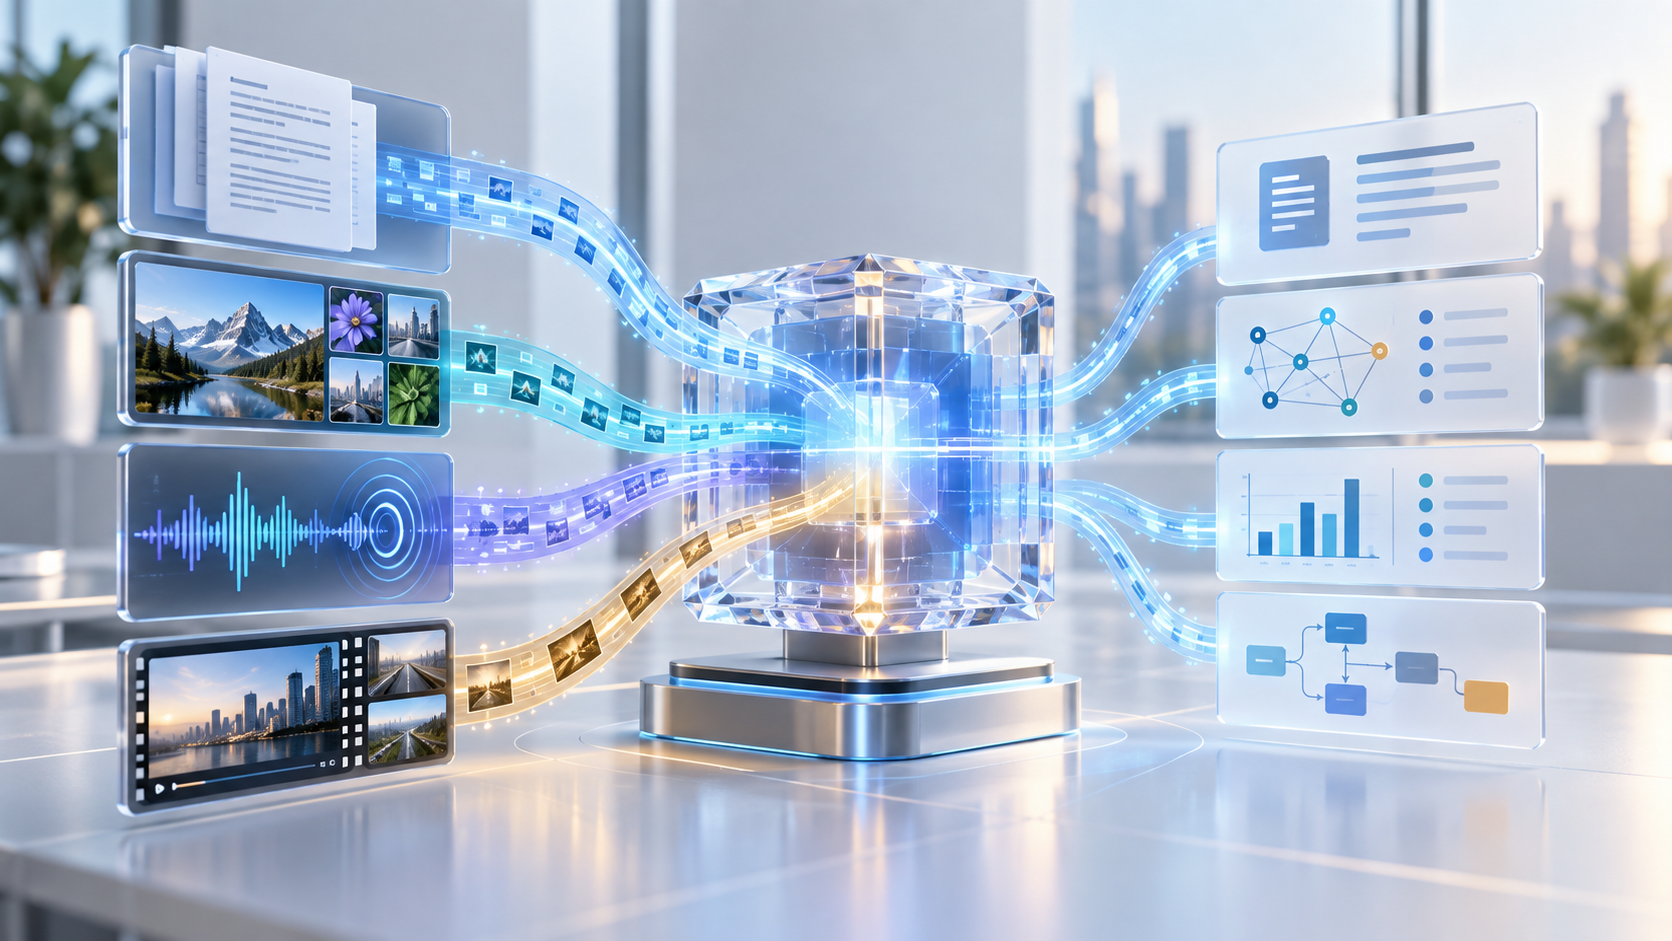
- Alibaba hat Qwen3.8-Omni-Flash am 18. September 2026 veröffentlicht. Das Modell verarbeitet Text, Bilder, Audio und Video in einem gemeinsamen Kontext.
- Es unterstützt laut offizieller Dokumentation bis zu eine Million Token, Function Calling, Websuche und mehrkanaliges räumliches Audio.
- „Omni“ bedeutet hier nicht beliebige Ausgabe: Das Modell liefert ausschließlich Text und erzeugt weder Sprache noch Bilder oder Videos direkt.
- Interessant sind Medienanalyse, Besprechungsprotokolle, Qualitätsprüfung und agentische Audio-/Video-Workflows. Die veröffentlichten Leistungsvergleiche sind zunächst Herstellerbenchmarks.
- Unternehmen sollten das Modell nur mit eigenen Testfällen, geklärter Datenregion und technischen Grenzen für Werkzeugaufrufe pilotieren.
Executive Summary
Qwen3.8-Omni-Flash verschiebt Multimodalität von einer Zusatzfunktion in Richtung einer gemeinsamen Arbeitsoberfläche für unstrukturierte Unternehmensdaten. Ein Modell kann eine Aufzeichnung hören, das Videobild auswerten, Begleitdokumente lesen und anschließend Werkzeuge aufrufen. Das vereinfacht Architektur und Prototyping. Es beseitigt jedoch weder Fehlerquellen noch Datenschutz- und Berechtigungsfragen. Der sinnvolle Beschaffungstest lautet deshalb nicht „Ist Qwen besser als Gemini?“, sondern: Liefert der gemeinsame Modellpfad bei den eigenen Medienprozessen mehr Qualität und weniger Integrationsaufwand als eine Kette spezialisierter Dienste?
Was Unternehmen jetzt tun sollten
- Einen klaren Medienprozess auswählen: etwa Besprechungsanalyse, Video-Qualitätsprüfung oder technische Dokumentation – nicht gleichzeitig einen universellen Assistenten bauen.
- Ein Referenzset anlegen: 30 bis 50 reale, freigegebene Fälle mit korrektem Soll-Ergebnis, schwierigen Audioabschnitten und bekannten Grenzfällen.
- Den bestehenden Prozess als Baseline messen: Qualität, Durchlaufzeit, Kosten, manuelle Nacharbeit und Fehler mit Geschäftswirkung vergleichen.
- Daten- und Aktionsgrenzen technisch erzwingen: Region, Aufbewahrung, Protokollierung, Werkzeugrechte und menschliche Freigaben vor dem ersten produktionsnahen Test festlegen.
- Erst nach einem Abnahmetest skalieren: Herstellerbenchmarks sind ein Auswahlsignal, aber kein Ersatz für eigene Medien, Sprachen, Akzente und Prozessregeln.
Was Alibaba konkret veröffentlicht hat
Das Qwen-Team bezeichnet Qwen3.8-Omni-Flash als „native omni-modal“. Nach der offiziellen Modellseite verarbeitet es Text, Bilder, Audio und Video gemeinsam und gibt Text aus. Die Alibaba-Cloud-Dokumentation nennt ein Kontextfenster von einer Million Token, maximal 131.072 Ausgabetoken, Function Calling, Websuche, Kontext-Caching und 113 unterstützte Sprachen beziehungsweise Dialekte für Audioeingaben.
Das Modell basiert laut Anbieter auf Qwen3.8-Flash-Next und ist auf agentische Aufgaben ausgerichtet. Gemeint ist damit nicht nur das Erkennen eines Bild- oder Audioinhalts. Qwen soll Medieninformationen in eine Arbeitskette übernehmen, planen, Werkzeuge aufrufen und ein Ergebnis liefern – beispielsweise eine strukturierte Zusammenfassung, einen Schnittplan oder eine Liste erkannter Qualitätsabweichungen.
Die Bezeichnung „multimodal“ braucht dennoch eine wichtige Einschränkung: Qwen3.8-Omni-Flash ist kein universelles Mediengenerierungsmodell. Es kann Audio und Video verstehen, erzeugt aber nur Text. Für synthetische Sprache, Bild- oder Videoausgabe sind weitere Modelle oder Werkzeuge nötig.
Der Dienst ist laut Dokumentation unter anderem in Frankfurt, Singapur, Hongkong, Tokio und Virginia verfügbar. Die Region muss über den zugehörigen API-Schlüssel gewählt werden. QwenCloud nennt zum Start öffentliche Listenpreise von 0,15 US-Dollar je Million Eingabetoken und 0,47 US-Dollar je Million Ausgabetoken; implizit gecachte Eingaben werden dort mit 0,016 US-Dollar je Million Token ausgewiesen. Das sind keine universell garantierten Endkundenpreise: Region, Alibaba-Cloud-Vertrag, Abrechnungsweg, Kontingente und zeitlich begrenzte Aktionen können die effektiven Kosten verändern. Für eine Beschaffung sind deshalb die Konditionen der tatsächlich gewählten Region und Plattform maßgeblich.
Für Qwen3.8-Omni-Flash veröffentlicht Alibaba zum Redaktionsschluss keine belastbare pauschale Umrechnung nach dem Muster „eine Audiostunde entspricht X Token“. Eine solche Daumenregel wäre irreführend, weil Dateiformat, Modalität, Videoanteil, Auflösung, Kontext und Ausgabeumfang die Abrechnung beeinflussen können. Ein Pilot sollte stattdessen die von der API gemeldeten Eingabe- und Ausgabetoken je Datei protokollieren und mit der einfachen Formel rechnen: Kosten pro Vorgang = Eingabetoken ÷ 1.000.000 × Eingabepreis + Ausgabetoken ÷ 1.000.000 × Ausgabepreis. Daraus lassen sich Median, 90. Perzentil und Kosten je verwertbarem Ergebnis für die eigenen Medien ableiten. Speicherung, Übertragung und manuelle Nachbearbeitung kommen hinzu.
Warum das für Unternehmen relevant ist
Viele multimodale Prozesse bestehen heute aus einer Kette: Transkription, Sprechertrennung, Bilderkennung, Dokumentenextraktion, Zusammenführung und anschließend ein Sprachmodell. Diese Architektur kann präzise und kontrollierbar sein, verursacht aber Integrationsaufwand und Informationsverluste zwischen den Stufen.
Ein gemeinsames Modell verspricht eine andere Logik. Es kann eine Besprechung nicht nur transkribieren, sondern Tonfall, Sprecherwechsel, eingeblendete Folien und den gesprochenen Kontext gemeinsam auswerten. Bei einem Wartungsvideo könnte es Bild, Maschinengeräusch und Arbeitsanweisung gleichzeitig berücksichtigen. Der geschäftliche Wert entsteht also weniger durch eine neue Chatoberfläche als durch eine potenziell kürzere Verarbeitungskette.
Genau darin liegt auch der Zielkonflikt: Eine vereinfachte Architektur bündelt Verantwortung in einem schwerer zerlegbaren Modell. Wenn das Ergebnis falsch ist, muss das Team unterscheiden können, ob Audioerkennung, visuelle Wahrnehmung, Schlussfolgerung oder Werkzeugaufruf versagt hat. Ohne Protokollierung und getrennte Prüfkriterien wird aus technischer Einfachheit operative Intransparenz.
Drei Einsatzfelder mit realistischem Nutzen
Besprechungen, Interviews und Servicegespräche
Mehrkanaliges Audio und Sprechertrennung sind für Protokolle, Interviews und Contact-Center-Analysen relevant. Ein Pilot sollte nicht nur die Wortfehlerrate messen. Wichtiger sind korrekt zugeordnete Entscheidungen, Verantwortliche, Fristen und Widersprüche. Bei personenbezogenen Aufzeichnungen braucht es vorab eine Rechtsgrundlage, transparente Information der Betroffenen sowie passende Lösch- und Zugriffskonzepte.
Video- und Qualitätsanalyse
In Produktion, Logistik oder Schulung kann ein Modell Videobilder mit Sprache, Geräuschen und technischen Unterlagen verbinden. Ein realistischer Einstieg ist eine assistive Prüfung: Das System markiert auffällige Sequenzen und begründet sie, eine fachkundige Person entscheidet. Sicherheitskritische Freigaben oder automatische Eingriffe in Anlagen gehören nicht in die erste Ausbaustufe.
Medienproduktion und Wissensarbeit
Qwen nennt Videoediting, Filmkommentar und Multimedia-Zusammenfassung als Einsatzfelder. Praktisch kann das Modell Rohmaterial sichten, Themen, Zitate und Szenen auffinden oder einen Schnitt- und Veröffentlichungsplan erzeugen. Weil die Ausgabe textbasiert bleibt, braucht es für die tatsächliche Bearbeitung kontrollierte Werkzeuge. Deren Rechte sollten auf definierte Dateien, Verzeichnisse und reversible Aktionen begrenzt sein.
Was die Benchmarks zeigen – und was nicht
Das Qwen-Team berichtet deutliche Fortschritte gegenüber Qwen3.5-Omni-Plus. In den veröffentlichten Agententests erreicht Qwen3.8-Omni-Flash 71,0 Punkte auf WildClawBench-MM, 69,6 auf UniClawBench, 36,8 auf AgenticVBench und 74,0 auf OmniGAIA. Im Vergleich zu Gemini 3.8 Flash liegt Qwen in den ersten beiden Werten vorn, in den beiden anderen zurück. Damit stützt selbst die Herstellertabelle keinen pauschalen Gesamtsieg.
| Benchmark laut Qwen | Qwen3.8-Omni-Flash | Gemini 3.8 Flash | Einordnung |
|---|---|---|---|
| WildClawBench-MM | 71,0 | 58,9 | Qwen vorn |
| UniClawBench | 69,6 | 69,0 | nahezu gleich, Qwen knapp vorn |
| AgenticVBench | 36,8 | 45,0 | Qwen zurück |
| OmniGAIA | 74,0 | 78,6 | Qwen zurück |
Bei Audio meldet Alibaba besonders starke Ergebnisse, etwa bei der Trennung überlappender Sprecher. Bei reinen Videoaufgaben ist das Bild gemischt. Zudem wurden mehrere Agentenbenchmarks mit einem zusätzlichen Harness wie Claude Code oder OpenClaw durchgeführt. Gemessen wird damit eine Kombination aus Modell, Werkzeugumgebung und Testaufbau – nicht das Grundmodell isoliert.
Benchmark-Caveat: Die Werte stammen aus der Veröffentlichung des Qwen-Teams vom 18. September 2026. Unabhängige, reproduzierbare Prüfungen für deutschsprachige Besprechungen, DACH-Datensätze und betriebliche Audio-/Video-Prozesse liegen zum Redaktionsschluss nicht in ausreichender Breite vor. Die Ergebnisse begründen einen Pilot, aber keine Beschaffungsentscheidung.
Governance: Multimodalität vergrößert die Angriffsfläche
Audio- und Videodateien enthalten häufig mehr sensible Informationen als ein gezielt formulierter Textprompt: Stimmen, Gesichter, Standorte, Bildschirminhalte, Metadaten und zufällig aufgezeichnete Dritte. Vor einem Upload müssen Datenklassifikation, Verarbeitungsregion, Unterauftragsverarbeiter, Speicherung, Löschung und mögliche Nutzung für die Dienstverbesserung vertraglich geklärt werden. Die dokumentierte Verfügbarkeit einer Frankfurter Region beantwortet diese Fragen nicht automatisch.
Hinzu kommt indirekte Prompt-Injection. Eine Anweisung kann in einer Folie stehen, in einem QR-Code stecken oder in einer Tonspur gesprochen werden. Ruft das Modell Werkzeuge auf, könnte manipulierter Medieninhalt Aktionen auslösen. Eine menschliche Freigabe allein genügt nicht, wenn die Person Ziel, Datenumfang und Folgen des Aufrufs nicht erkennen kann.
Wann der EU AI Act besonders relevant wird
Multimodale Analyse ist nicht allein wegen ihrer Technik ein Hochrisiko-System. Nach Artikel 6 und Anhang III des EU AI Act kommt es vor allem auf den vorgesehenen Zweck und die Wirkung an. Eine Hochrisiko-Einordnung kann insbesondere relevant werden, wenn das System als Sicherheitskomponente eines regulierten Produkts eingesetzt wird oder Entscheidungen in Bereichen wie Biometrie, kritischer Infrastruktur, Bildung, Beschäftigung, Zugang zu wesentlichen Diensten, Strafverfolgung, Migration oder Justiz trifft beziehungsweise wesentlich beeinflusst.
Ein Modell, das ein internes Marketingvideo zusammenfasst, fällt deshalb nicht automatisch in dieselbe Risikoklasse wie ein System, das Bewerber anhand aufgezeichneter Interviews bewertet oder sicherheitskritische Wartungsentscheidungen vorbereitet. Unternehmen sollten den konkreten Anwendungszweck dokumentieren, mögliche Ausnahmen nicht pauschal voraussetzen und bei Personenbezug, Profiling oder erheblicher Entscheidungswirkung eine rechtliche Einzelfallprüfung vornehmen. Unabhängig von der Hochrisiko-Klassifizierung bleiben Datenschutz-, Transparenz-, Mitbestimmungs- und sektorspezifische Pflichten relevant.
Mindestkontrollen für einen produktionsnahen Pilot
- separate technische Identität mit minimalen Lese- und Schreibrechten;
- Allowlist für Werkzeuge, Dateitypen, Ziele und maximale Transaktionsreichweite;
- Malware- und Inhaltsprüfung vor der Modellverarbeitung;
- vollständige Protokollierung von Eingaben, Werkzeugaufrufen, Freigaben und Ergebnissen;
- explizite Freigabe für irreversible, externe oder personenbezogene Aktionen;
- Tests mit sichtbaren, versteckten und gesprochenen Prompt-Injections.
Ein belastbarer Pilot in vier Wochen
Ein mittelständisches Industrieunternehmen möchte Wartungsvideos schneller auswerten. Das folgende Beispiel ist ein hypothetisches, aber realistisches Testszenario.
In Woche eins wählt das Team 40 bereits abgeschlossene und intern freigegebene Videos aus. Fachleute markieren die korrekten Arbeitsschritte, Abweichungen, relevanten Geräusche und Stellen mit unklarer Evidenz. Personenbezogene Inhalte werden entfernt oder pseudonymisiert.
In Woche zwei laufen Qwen3.8-Omni-Flash und der bestehende Prozess gegen dasselbe Referenzset. Bewertet werden Trefferquote kritischer Abweichungen, falsche Warnungen, nachvollziehbare Fundstellen, Bearbeitungszeit und Kosten pro verwertbarem Ergebnis. Das Modell erhält noch keinen Werkzeugzugriff.
In Woche drei darf es ausschließlich Entwürfe für Prüfberichte erzeugen. Fachleute bewerten blind, ob Befunde korrekt, vollständig und durch Zeitmarken belegbar sind. Ein Red-Team-Test platziert irreführende Anweisungen in Bild, Sprache und Metadaten.
In Woche vier entscheidet das Team anhand vorher definierter Grenzwerte. Kritische Fehler müssen vollständig erkannt werden; falsche Warnungen und Nacharbeit dürfen die Baseline nicht verschlechtern. Verfehlt das Modell diese Kriterien, bleibt es bei einer Recherchehilfe oder wird verworfen. Erst nach bestandener Abnahme folgt ein begrenzter, weiterhin beaufsichtigter Produktionspilot.
Qwen oder eine Kette spezialisierter Modelle?
Ein Omni-Modell ist nicht automatisch die bessere Architektur. Für standardisierte Transkription kann ein spezialisierter Dienst günstiger, leichter messbar und datenschutzrechtlich einfacher einzugrenzen sein. Für Prozesse, in denen Bild, Ton, Video und Dokumente eng zusammenwirken, kann der gemeinsame Kontext dagegen Integrationsaufwand reduzieren und Zusammenhänge erhalten.
| Kriterium | Omni-Modell | Kette spezialisierter Modelle |
|---|---|---|
| Integrationsaufwand | Weniger Übergaben und ein gemeinsamer Kontext | Mehr Schnittstellen und Orchestrierung |
| Fehlersuche | Ursachen im Gesamtmodell schwerer zu isolieren | Fehler je Verarbeitungsschritt besser eingrenzbar |
| Datenschutz-Eingrenzung | Mehr Modalitäten und Datenarten beim selben Anbieter | Datenflüsse je Spezialdienst gezielter trennbar |
| Kostenmessbarkeit | Ein API-Pfad, aber neue multimodale Verbrauchslogik | Einzelkosten transparenter, Gesamtkette aufwendiger |
| Geeignetes Einsatzprofil | Eng verbundene Bild-, Ton-, Video- und Textaufgaben | Standardisierte Einzelaufgaben mit klaren Qualitätsmetriken |
Entscheidend bleibt, ob der Mehrwert tatsächlich aus der Verbindung mehrerer Modalitäten entsteht, Fehler noch ausreichend prüfbar bleiben und der geringere Integrationsaufwand die zusätzliche Anbieterabhängigkeit überwiegt.
Wenn nur eine Modalität geschäftskritisch ist, sollte ein spezialisiertes Modell Teil des Vergleichs bleiben. Wenn mehrere Modalitäten gemeinsam die Entscheidung tragen, ist Qwen3.8-Omni-Flash ein plausibler Evaluierungskandidat.
FAQ
Ist Qwen3.8-Omni-Flash Open Source?
Für Qwen3.8-Omni-Flash ist zum Veröffentlichungszeitpunkt ein gehosteter API-Dienst dokumentiert. Eine offene Modellkarte mit herunterladbaren Gewichten und einer Open-Source- oder Open-Weight-Lizenz liegt für dieses konkrete Modell nicht vor. Offene Gewichte anderer Qwen-Modelle dürfen nicht auf Omni-Flash übertragen werden.
Kann das Modell Bilder, Audio oder Videos erzeugen?
Nein. Es akzeptiert Text, Bilder, Audio und Video als Eingabe, gibt laut offizieller Dokumentation aber nur Text aus. Für Mediengenerierung sind zusätzliche Modelle und Werkzeuge nötig.
Ist Qwen3.8-Omni-Flash in Europa verfügbar?
Alibaba Cloud führt Deutschland (Frankfurt) als unterstützte Region. Unternehmen müssen dennoch Datenverarbeitung, Vertragsgrundlage, Speicherung, Unterauftragsverarbeiter und technische Konfiguration im konkreten Angebot prüfen.
Ersetzt eine Million Token Kontext ein Wissenssystem?
Nein. Ein großes Kontextfenster erlaubt umfangreiche Eingaben, garantiert aber weder vollständigen Abruf noch richtige Schlussfolgerungen. Quellensteuerung, Berechtigungen, Aktualität und Evaluation bleiben notwendig.
Für wen lohnt sich ein früher Test?
Vor allem für Unternehmen mit volumenstarken Audio-/Video-Prozessen, mehreren eng verbundenen Modalitäten und einem messbaren Referenzprozess. Für reine Text- oder Standardtranskriptionsaufgaben ist ein spezialisierter Vergleich häufig sinnvoller.
Fazit: Ein Integrationskandidat, kein automatischer Modellwechsel
Qwen3.8-Omni-Flash ist mehr als ein weiterer Chatbot. Die Kombination aus Text-, Bild-, Audio- und Videoverständnis, langem Kontext und Werkzeugaufrufen kann Medienprozesse vereinfachen, die heute aus mehreren Diensten bestehen. Besonders für Besprechungs-, Video- und Qualitätsanalyse verdient das Modell einen Platz auf der Evaluierungsliste.
Die Veröffentlichung rechtfertigt keinen pauschalen Wechsel. Die Leistungsvergleiche stammen vom Hersteller, und der gemeinsame Modellpfad erschwert die Fehlerdiagnose. Unternehmen sollten deshalb einen eng begrenzten Prozess mit eigenem Referenzset testen. Erst wenn Qualität, Kosten, Datenschutz und kontrollierter Werkzeugzugriff gemeinsam überzeugen, wird aus einer interessanten Modellankündigung eine tragfähige Unternehmenslösung.
Quellen
- Qwen Team: Qwen3.8-Omni-Flash: Omni Senses. Agentic Delivery, 18. September 2026.
- QwenCloud: Qwen3.8-Omni-Flash – Modellseite, Preise und API, abgerufen am 18. September 2026.
- Alibaba Cloud Model Studio: qwen3.8-omni-flash – Fähigkeiten, Regionen und Kontextgrenzen, Stand 17. September 2026.
- Alibaba Cloud Model Studio: Qwen-Omni – Abrechnung und Tokenlogik für Modalitäten, abgerufen am 18. September 2026.
- QwenCloud Docs: Model releases – qwen3.8-omni-flash, 18. September 2026.
- Europäische Union: Verordnung (EU) 2024/1689 – AI Act, Amtsblatt der Europäischen Union.
- Europäische Kommission: AI Act – regulatorischer Rahmen und Risikoklassen, abgerufen am 18. September 2026.