Zuletzt aktualisiert: 6. Oktober 2026 · Version: 1.3
Redaktionshinweis: Dieser Artikel wurde mit KI-Unterstützung recherchiert und überarbeitet sowie nach redaktioneller Durchsicht zur Veröffentlichung freigegeben. Die technischen Angaben stammen aus Googles Dokumentation und sind als Herstellerangaben gekennzeichnet. Eigene Praxistests wurden nicht durchgeführt.
In 30 Sekunden
- Google hat am 6. Oktober 2026 EmbeddingGemma 2 vorgestellt. Das Modell verarbeitet Text, Code, Bilder, Videoframes und Audio für semantische Suche.
- Laut Google steht es unter Apache 2.0 bereit und lässt sich lokal betreiben.
- Je nach benötigten Eingabeformaten werden zwischen 270 und 740 Millionen Parametern geladen.
- Für Unternehmen eröffnet das neue Möglichkeiten, unterschiedliche Wissensbestände gemeinsam zu durchsuchen. Ob die Trefferqualität genügt, muss ein Test mit eigenen Daten zeigen.
Quelle: Google Developer Guide.
Empfehlung für IT- und Plattformteams
Wählen Sie einen begrenzten Suchfall aus, bei dem die bisherige Textsuche wichtige Informationen übersieht. Vergleichen Sie dieselben Suchaufgaben mit der bestehenden Lösung und EmbeddingGemma 2. Legen Sie vorab fest, welche Treffer fachlich richtig sind und welche Antwortzeit auf den vorgesehenen Geräten akzeptabel ist.
Wenn die passende Information in einem Bild steckt
Eine Serviceabteilung sucht nach einer Störung. Die Erklärung steht im Wartungshandbuch, das passende Schadensbild liegt im Fotoarchiv und der Reparaturschritt steckt in einer Videoaufzeichnung. Für Beschäftigte gehört das zusammen. Für eine klassische Suchlösung sind es häufig getrennte Bestände.
EmbeddingGemma 2 soll solche Inhalte gemeinsam durchsuchbar machen. Das Modell erzeugt numerische Repräsentationen, sogenannte Embeddings. Inhaltlich ähnliche Informationen können dadurch auch über unterschiedliche Medienformate hinweg gefunden werden. Wie die Suche mit solchen Repräsentationen funktioniert, erklärt unser Beitrag Vektordatenbanken einfach erklärt.
Google beschreibt einen gemeinsamen Vektorraum mit 768 Dimensionen. Die Model Card nennt mehr als 100 unterstützte Sprachen und ein gemeinsames Kontextfenster von 8.192 Tokens. Diese Angaben beschreiben Fähigkeiten und Grenzen des Modells; sie belegen noch keine zuverlässige Suche in deutschen Fachunterlagen.
Video wird dabei über einzelne Frames verarbeitet; Google nennt standardmäßig ein Bild pro Sekunde. Lange Aufzeichnungen müssen passend zum Kontextfenster segmentiert werden. Eine kurze Bewegung zwischen zwei abgetasteten Frames kann so unberücksichtigt bleiben; die passende Abtastrate gehört deshalb in den fachlichen Test.
Was sich gegenüber einer mehrstufigen Such-Pipeline ändert
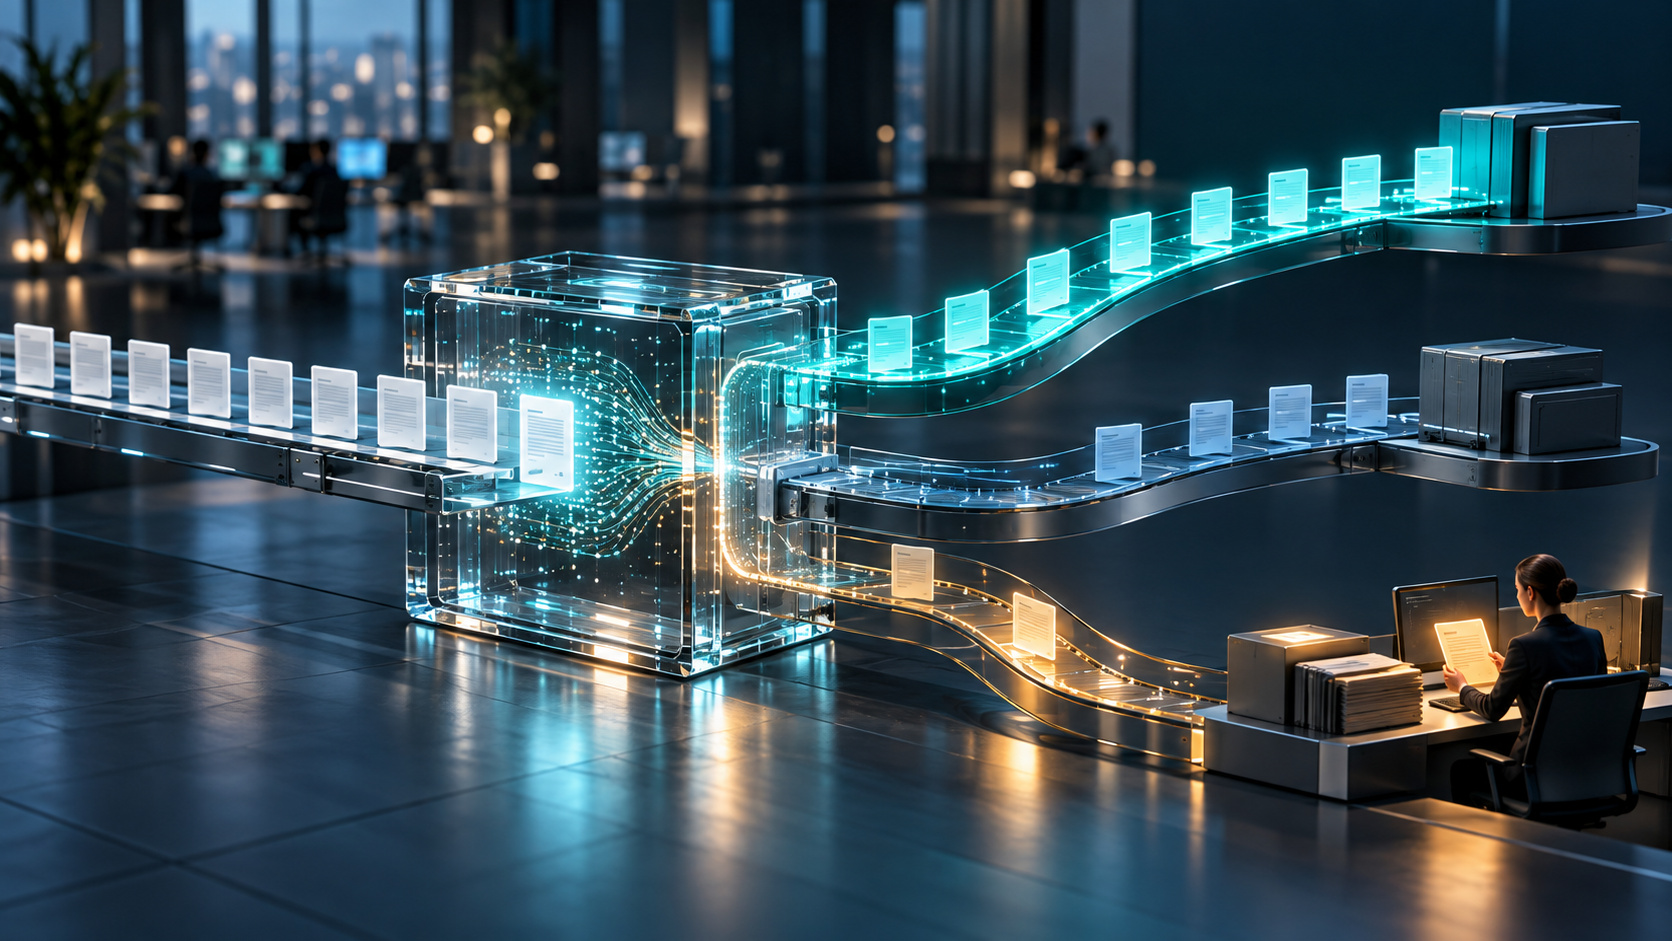
Eine verbreitete Architektur übersetzt Bilder zunächst in Beschreibungen und Audio in Transkripte. Anschließend erzeugt ein Text-Embedding-Modell die Suchvektoren. EmbeddingGemma 2 kann Bild-, Audio- und Texteingaben direkt in denselben Vektorraum abbilden. Google nennt als Vorteil weniger Latenz und Speicheraufwand gegenüber solchen Modellketten. Quelle: Google AI Edge.
Das kann den Betrieb vereinfachen und Informationen auffindbar machen, die in einer Bildbeschreibung oder einem Transkript fehlen. Es ist aber kein Beleg dafür, dass jede bestehende Pipeline ersetzt werden sollte. Transkripte bleiben etwa für zitierbare Wortlaute nützlich; Textextraktion und OCR helfen bei exakten Artikelnummern. Für die Unternehmensentscheidung zählt, ob der gemeinsame Index bei den eigenen Suchaufgaben besser abschneidet als die bisherige Lösung.
Der praktische Vorteil: modular ladbare Encoder
Unternehmen müssen nicht alle Komponenten laden. Laut Model Card bilden 270 Millionen Parameter die Textbasis; dazu kommen optional 170 Millionen für Vision und 300 Millionen für Audio. Die Kombinationen ergeben folgende Stufen:
| Benötigte Inhalte | Modellumfang laut Google |
|---|---|
| Text und Code | 270 Millionen Parameter |
| Zusätzlich Bilder und Video | 440 Millionen (270 + 170) |
| Text und Audio | 570 Millionen (270 + 300) |
| Alle Modalitäten | 740 Millionen (270 + 170 + 300) |
Damit lässt sich der Ressourcenbedarf an den konkreten Suchfall anpassen. Google dokumentiert außerdem verkürzte Vektoren, die Speicher sparen können. Dieser Vorteil ist gegen mögliche Verluste bei der Trefferqualität abzuwägen. Quelle: Google Developer Guide.
Die redaktionelle Einordnung: Interessant ist vor allem die Möglichkeit, eine lokale Unternehmenssuche schrittweise um weitere Medien zu erweitern. Dafür braucht es weiterhin Datenaufbereitung, einen Suchindex, Berechtigungen und eine verständliche Ergebnisanzeige. Der Modellumfang allein sagt zudem wenig über den gesamten Speicherbedarf einer Anwendung aus.
Hardware: Googles Speicherwerte richtig einordnen
Google nennt auf einem Pixel 11 Pro etwa 191 MB aktiven RAM für die Textgewichte und rund 567 MB für das vollständige multimodale Modell. Das sind herstellerspezifische Werte der gezeigten Edge-Implementierung, keine allgemeine Mindestanforderung für Laptops oder Server. Quelle: Google AI Edge.
Für eine Suchanwendung kommen unter anderem Medienaufbereitung, Laufzeitpuffer, Vektorindex, Metadaten und Benutzeroberfläche hinzu. Gleichzeitige Anfragen erhöhen den Ressourcenbedarf zusätzlich. IT-Teams sollten daher den maximalen Speicherverbrauch und die Suchlatenz mit repräsentativen Dateien auf der Zielhardware messen.
Illustrative Speicherrechnung: Eine Million Vektoren mit 768 Dimensionen benötigt bei Float32 allein für die Zahlenwerte rund 3,07 GB (1.000.000 × 768 × 4 Byte). Indexstrukturen, Metadaten und Replikate sind darin noch nicht enthalten. Modell-RAM und Indexspeicher sind somit getrennte Planungsgrößen.
Google beschreibt Integrationswege über AI Edge und LiteRT. Die Android-Integration über ML Kit ist zum Quellenstand für die kommenden Wochen angekündigt; sie sollte noch nicht als bereits verfügbare Voraussetzung eines Piloten eingeplant werden. Quelle: Google AI Edge.
Ein realistischer Einsatzfall im technischen Service
In einem hypothetischen Praxisbeispiel indexiert ein Maschinenbauer freigegebene Handbuchauszüge, Schadensfotos und kurze Schulungssequenzen. Beschäftigte suchen mit einer Fehlerbeschreibung nach passenden Fundstellen.
Ein Pilot sollte drei Fragen beantworten: Werden relevante Ergebnisse häufiger gefunden? Bleiben ähnliche, aber falsche Bauteile unterscheidbar? Ist die Suche auf den vorgesehenen Geräten schnell genug? Der Fachbereich bewertet die Fundstellen; das Plattformteam misst Laufzeit, Speicherbedarf und Pflegeaufwand.
Grenze der bisherigen Evidenz: Google positioniert EmbeddingGemma 2 für lokale Anwendungen und bietet Integrationswege über Google AI Edge. Die dort gezeigten Leistungswerte sind Herstellerangaben und lassen sich nicht ungeprüft auf vorhandene Firmenhardware übertragen. Für diesen Artikel wurden keine eigenen Benchmarks durchgeführt. Quelle: Google AI Edge.
Eine minimale Architektur für den Pilot
Indexierung: Freigegebene Dokumenten- und Medienquellen → Chunking beziehungsweise Segmentierung → EmbeddingGemma 2 → Vektorindex mit Quellen-, Versions- und Rechtemetadaten.
Suchanfrage: Angemeldeter Nutzer → Anfrage-Embedding → Suche mit Berechtigungsfilter → Trefferliste mit Originalquelle und gegebenenfalls Zeitcode.
Die Rechteprüfung greift vor oder während der Suche und jedenfalls vor jeder Ausgabe an Nutzer oder ein nachgelagertes Sprachmodell. Berechtigungen, Versionswechsel und Löschungen müssen von der Quelle bis zum Index nachgeführt werden. Ein gemeinsamer Vektorraum übernimmt diese Aufgaben nicht.
Für den Vergleich stellt der Servicebereich einen abgegrenzten Bestand und fachlich bewertete Suchfragen zusammen. Beide Lösungen erhalten dieselben Aufgaben. Recall misst, welcher Anteil relevanter Fundstellen gefunden wird; Präzision, welcher Anteil der ausgegebenen Treffer relevant ist. Beide Werte werden bei derselben Anzahl angezeigter Treffer verglichen. Ergänzend erfasst das Plattformteam Antwortzeit, Spitzen-RAM, Indexgröße und Betriebsaufwand. Gesperrte Inhalte dürfen in den Berechtigungstests weder als Treffer noch als Vorschautext erscheinen.
In zwei Wochen zu einer belastbaren Pilotentscheidung
Redaktioneller Planungsvorschlag: Die folgenden Mengen und Zeiträume sind illustrative Startwerte, keine Google-Vorgaben oder berichteten Projektergebnisse. Der Ablauf setzt freigegebene Daten und eine vorhandene Testumgebung voraus.
- Tag 1–3 – Bestand und Vergleich festlegen: 50–200 Dokumente, 20–50 Fotos und 5–10 Kurzvideos zu einem klar begrenzten Servicefall auswählen. Fachlich bewertete Suchfragen, Nutzerrollen und Abnahmekriterien gemeinsam mit dem Servicebereich festlegen.
- Tag 4–6 – Index aufbauen: Dokumente und Medien segmentieren, Embeddings erzeugen und mit Quellen-, Versions- und Rechtemetadaten in einen Vektorindex laden. Dieselben Suchaufgaben für die bisherige Lösung vorbereiten.
- Tag 7–8 – Zugriff und Lebenszyklus prüfen: Gesperrte Inhalte, entzogene Rechte, gelöschte Dateien und veraltete Versionen testen. Trefferlisten und Vorschautexte dürfen keine unberechtigten Inhalte offenlegen.
- Tag 9–10 – Vergleich auswerten: Recall, Präzision, Antwortzeit und Betriebsaufwand erfassen. Fachbereich und IT entscheiden anhand der vorher vereinbarten Kriterien über Fortsetzung, Nacharbeit oder Abbruch.
Der Testumfang soll überschaubar bleiben, aber schwierige Fälle enthalten: ähnlich aussehende Bauteile, uneindeutige Fehlerbeschreibungen und unterschiedliche Bezeichnungen für denselben Vorgang. Ein schneller Demonstrator allein begründet noch keinen produktiven Rollout.
Lokale Verarbeitung braucht weiterhin Zugriffskontrollen
Lokal bedeutet zunächst: Das Embedding-Modell läuft auf eigener Hardware. Speicher, Index, Zugriffskontrolle und Protokollierung bleiben eigenverantwortlich zu betreiben. Das kann Datenübertragungen an externe Dienste reduzieren. Entscheidend bleibt die vollständige Anwendung: Wo liegen Originaldateien, Index und Protokolle? Welche Nutzer dürfen welche Treffer sehen? Für die Architekturentscheidung ist diese Datenflussanalyse ebenso wichtig wie die Wahl des Modells.
Technische Anforderung für den Pilot: Testen Sie ausgeschlossene Dokumente, entzogene Berechtigungen und gelöschte Inhalte. Ein ähnlicher Suchtreffer darf keine Zugriffsentscheidung ersetzen. Rechtefilter müssen auch für Bilder, Audio und Videosegmente gelten.
Bei einem kleinen, freigegebenen Bestand kann dafür ein schlanker Testkatalog genügen. Werden sensible Inhalte oder mehrere Nutzergruppen eingebunden, sollten Rechtevererbung, Löschung und Protokollierung systematisch geprüft werden. Die strategische Einordnung vertieft unser Praxisleitfaden zur digitalen Souveränität bei KI.
FAQ
Erzeugt EmbeddingGemma 2 fertige Antworten?
Sein Ergebnis sind Embeddings. Eine Anwendung kann damit relevante Inhalte finden; für ausformulierte Antworten benötigt sie zusätzliche Komponenten.
Welche Hardware braucht EmbeddingGemma 2?
Eine pauschale RAM- oder GPU-Mindestanforderung lässt sich aus Googles Pixel-Messung nicht ableiten. Maßgeblich sind die gewählten Encoder, Laufzeit, Rechenpräzision, Dateigrößen und parallelen Anfragen. Für die Kapazitätsplanung ist der gesamte Suchprozess einschließlich Index auf der Zielhardware zu messen.
Kann EmbeddingGemma 2 Deutsch?
Google positioniert das Modell mehrsprachig mit Unterstützung für über 100 Sprachen. Daraus folgt keine gleichmäßige Qualität für alle Sprachen oder Fachdomänen. Für deutsche Unternehmensdaten sollten zusammengesetzte Fachbegriffe, Abkürzungen und gemischte deutsch-englische Anfragen eigens getestet werden. Quelle: Google Model Card.
EmbeddingGemma 2 oder klassische OCR-Suche?
OCR macht Text aus Scans maschinenlesbar; semantische Embeddings helfen beim Finden inhaltlich verwandter Informationen. Für exakte Seriennummern kann eine Suche im extrahierten Text weiterhin wichtig sein. Als redaktionelle Empfehlung lohnt deshalb auch ein Vergleich mit einer hybriden Suche aus Volltext und Vektorsuche.
Ist es dasselbe wie Gemini Embedding 2?
Nein. Gemini Embedding 2 ist ein separates Google-Angebot. Produktnamen und Betriebsmodelle sollten bei der Architekturentscheidung sauber getrennt werden. Quelle: Google zu Gemini Embedding 2.
Fazit
EmbeddingGemma 2 ist ein Anlass, bisher schwer zugängliche Medienbestände in die Unternehmenssuche einzubeziehen. Starten Sie mit einem abgegrenzten Bestand aus Handbüchern, Fotos und kurzen Videos. Vergleichen Sie Recall, Präzision, Antwortzeit und Betriebsaufwand mit der bestehenden Suche. Eine Ausweitung ist erst begründet, wenn der fachliche Mehrwert messbar ist und die Berechtigungs- und Löschtests bestanden sind.
Quellen
Quellenstand: 6. Oktober 2026. Produktangaben stammen aus den folgenden Herstellerquellen:
- Google: EmbeddingGemma 2 – The Developer Guide
- Google: EmbeddingGemma 2 Model Card
- Google: Multimodal semantic search with EmbeddingGemma 2 and AI Edge
- Google: Gemini Embedding 2 – separates Produkt zur Abgrenzung