Zuletzt aktualisiert: 16. September 2026 · Version: 1.3
Redaktionshinweis: Dieser Artikel wurde mit KI-Unterstützung recherchiert und überarbeitet sowie menschlich redaktionell geprüft. Produktangaben, Preise und technische Grenzen stammen überwiegend aus der Dokumentation und den Modellkarten der jeweiligen Anbieter; unabhängige Vergleichsdaten aus produktiven deutschsprachigen Sprachagenten liegen unmittelbar nach der Veröffentlichung nur begrenzt vor. Funktionen können je nach API, Cloud-Dienst, Region und Unternehmenskonto abweichen. Quellenstand: 16. September 2026.
⚡ In 30 Sekunden
- Google hat am 15. September 2026 Gemini 3.8 Live und Gemini 3.8 Live Extended Thinking als stabile Audio-zu-Audio-Modelle für die Live API veröffentlicht.
gemini-3.8-livepriorisiert kurze Reaktionszeiten.gemini-3.8-live-extended-thinkingkann im Hintergrund weiterdenken und asynchrone Werkzeuge aufrufen, während es gesprochene Zwischenstände liefert.- Beide Modelle verarbeiten Text, Bild, Audio und Video, geben Text und Audio aus und bieten 131.072 Eingabe- sowie 65.536 Ausgabetoken.
- Die Standardpreise liegen bei 0,005 US-Dollar je Minute Audioeingabe und 0,018 US-Dollar je Minute Audioausgabe. Text, Bilder, Video, Suche, Telefonie und Betrieb können zusätzliche Kosten verursachen.
- Im Wettbewerb gibt es keinen pauschalen Sieger: GPT-Live-1, Azure Voice Live und Amazon Nova 2 Sonic setzen andere Schwerpunkte bei Architektur, Cloud-Integration, Regionen und Betriebsmodell.
✅ Kurzentscheidung für Unternehmen
Innerhalb der Gemini Live API ist Gemini 3.8 Live der sinnvolle Ausgangspunkt für klar begrenzte, zeitkritische Sprachdialoge. Extended Thinking gehört nur in Prozesse, in denen mehrstufige Recherche oder langsame Werkzeuge einen nachweisbaren Mehrwert liefern. Ist der Technologie-Stack noch offen, sollten Unternehmen Gemini, OpenAI, Azure und AWS mit demselben reversiblen Gesprächspfad vergleichen. Maßgeblich sind Kosten pro korrekt gelöstem Anliegen sowie eine Zustands-, Abbruch- und Rechtekontrolle außerhalb des Modells.
Bei Sprachagenten entscheidet nicht nur, wie natürlich eine Stimme klingt. Entscheidend ist, ob das System während eines Gesprächs zuverlässig zwischen Zuhören, Antworten, Nachdenken und Handeln unterscheiden kann. Genau hier setzt Googles neue Modellfamilie an: Gemini 3.8 Live optimiert den direkten Dialog, Extended Thinking erweitert denselben Kanal um Hintergrund-Reasoning und asynchrone Werkzeugketten.
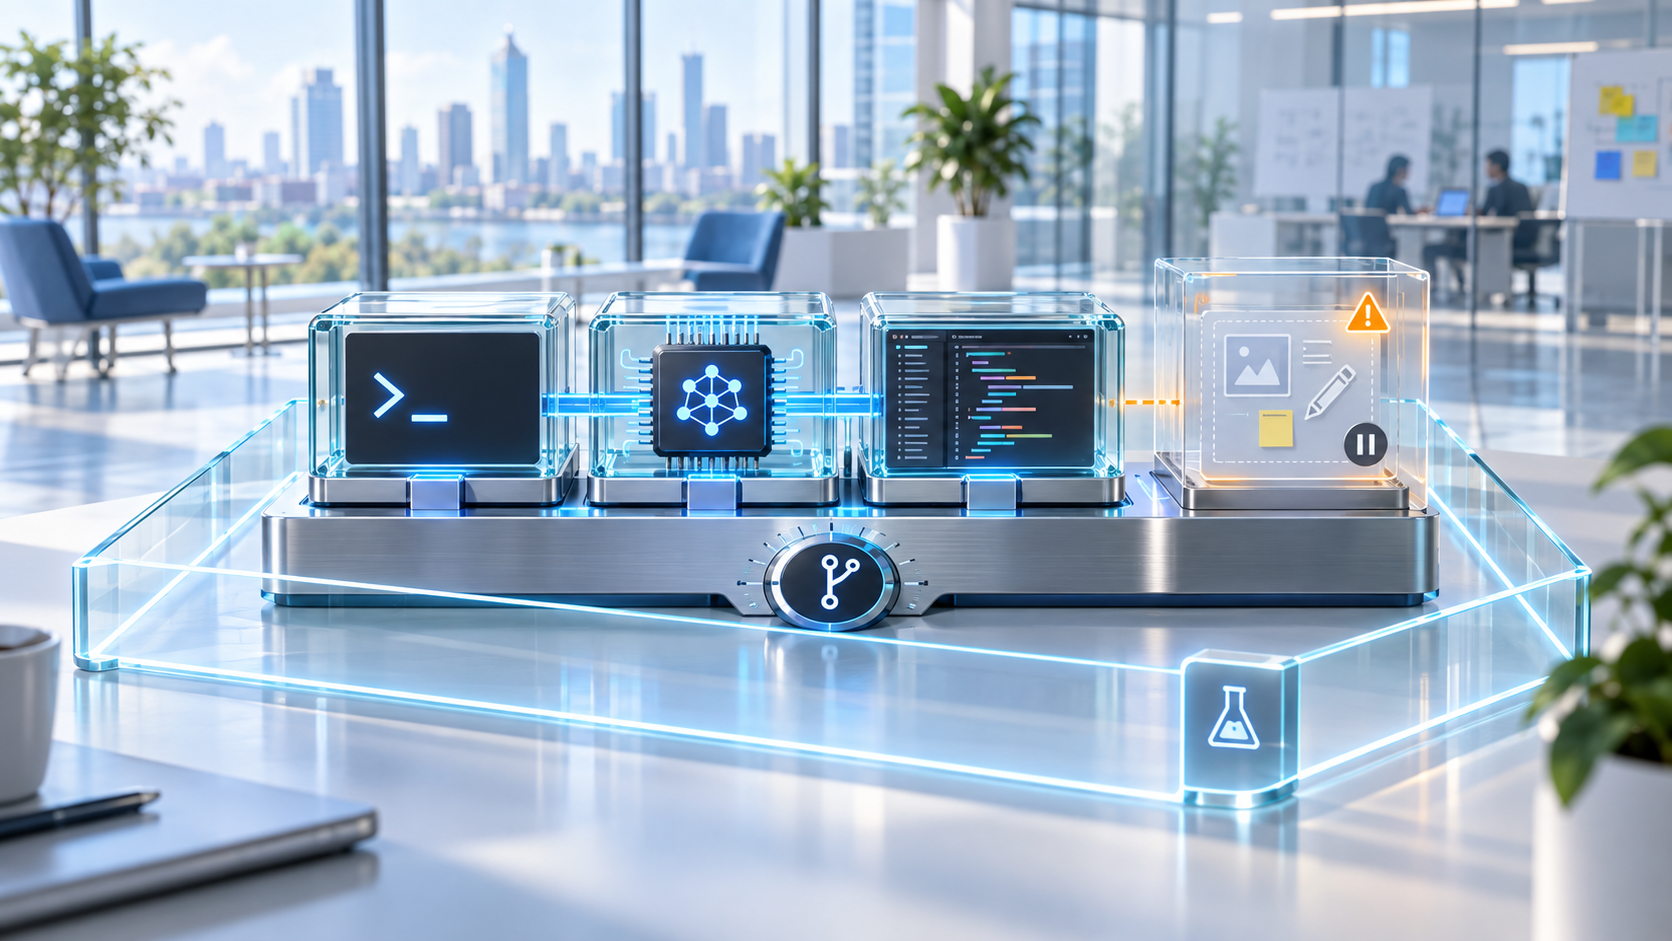
Damit entsteht eine relevante Architekturentscheidung. Ein schneller Agent kann einen einfachen Servicefall flüssig bearbeiten. Ein denkender Agent kann komplexere Abläufe koordinieren, braucht aber mehr Zustandsmanagement, engere Rechte und belastbare Abbruchregeln. Wer nur den Modellnamen austauscht, unterschätzt die technische und organisatorische Migration.
Was Google veröffentlicht hat
Die Gemini-API-Release-Notes führen seit dem 15. September 2026 zwei stabile Modelle:
| Kriterium | Gemini 3.8 Live | Extended Thinking |
|---|---|---|
| Primärer Zweck | Direkter Echtzeitdialog mit niedriger Latenz | Komplexe, mehrstufige Aufgaben im laufenden Sprachdialog |
| Reasoning | Interleaved Reasoning mit festem Latenzprofil | Konfigurierbares Hintergrund-Reasoning: low, medium oder high |
| Tool-Aufrufe | Asynchron als Standard; blockierend weiter möglich | Nur asynchron und nicht blockierend |
| Sitzungsende | turnComplete signalisiert wieder Leerlauf | interaction_status entscheidet zwischen IN_PROGRESS und IDLE |
| Typische Nutzung | Triage, Statusauskunft, Terminierung, Sprachsuche | Diagnose, Reiseplanung, mehrstufige Recherche, erklärendes Tutoring |
Beide Modelle akzeptieren laut Modellseite zu Gemini 3.8 Live Text, Bilder, Audio und Video. Sie geben Text und Audio aus, unterstützen Function Calling und Google-Suche, aber weder Code Execution, File Search, URL Context noch strukturierte Ausgaben. Das Kontextfenster umfasst 131.072 Eingabetoken, die maximale Ausgabe 65.536 Token.
Wichtige Abgrenzung: „Live“ bezeichnet die Echtzeit-API und die native Audioverarbeitung. Das Modell ist damit noch kein vollständiger Telefonagent. SIP- oder Carrier-Anbindung, CRM-Zugriff, Identitätsprüfung, Geschäftslogik, Monitoring und menschliche Übergabe bleiben Aufgaben der Anwendung beziehungsweise der Plattform.
Der eigentliche Fortschritt: Denken ohne stummen Kanal
Ein Sprachagent wirkt schnell unbrauchbar, wenn er während einer Datenbankabfrage schweigt oder einen komplexen Auftrag zu früh beantwortet. Extended Thinking soll diesen Zielkonflikt entschärfen. Das Modell kann eine laufende Interaktion als IN_PROGRESS markieren, Werkzeuge asynchron aufrufen und gesprochene Zwischenmeldungen ausgeben. Erst interaction_status: IDLE zeigt, dass die gesamte Aufgabe abgeschlossen ist.
Das ist mehr als eine Komfortfunktion. Die Anwendung muss nun zwischen einem abgeschlossenen Sprechabschnitt und einem abgeschlossenen Geschäftsprozess unterscheiden. Ein turnComplete-Signal kann bei Extended Thinking lediglich bedeuten, dass eine Zwischenmeldung beendet ist. Wer an dieser Stelle die Oberfläche entsperrt, einen zweiten Auftrag annimmt oder die Verbindung schließt, riskiert doppelte Aktionen, verlorene Tool-Ergebnisse und inkonsistente Zustände.
Zwischenstand geben
Der Agent bestätigt den Auftrag und erklärt knapp, welcher Schritt gerade läuft.
Tools asynchron nutzen
Recherche, Prüfung und Datenabrufe laufen im Hintergrund mit explizitem Status.
Ergebnis kontrollieren
Erst nach Tool-Ergebnis, fachlicher Prüfung und IDLE-Status gilt der Vorgang als beendet.
Migration: Ein Modellstring reicht nicht
Google empfiehlt die neuen Modelle als Nachfolger für gemini-3.1-flash-live-preview. Für Gemini 3.8 Live muss der Modellstring geändert und eine vorhandene thinking_level- beziehungsweise thinking_config-Konfiguration entfernt werden. Proaktive Audioausgabe ist dauerhaft aktiv; der Versuch, sie zu deaktivieren, führt laut Dokumentation zu einem Fehler. Die frühere Option für „affective dialogue“ entfällt.
Bei Extended Thinking ist der Umbau größer. Tool-Deklarationen müssen nicht blockierend sein, die Anwendung muss nach einem turnComplete weiter auf Ereignisse hören und den Interaktionsstatus verwalten. Auch Abbruchlogik, Wiederanlauf, Idempotenz und Benutzeroberfläche müssen auf mehrteilige Antworten ausgelegt sein.
Migrationscheck in fünf Punkten
- Modell-ID und entfernte Konfigurationsfelder in einer isolierten Umgebung testen.
- Jeden Tool-Aufruf mit eindeutiger Vorgangs-ID, Timeout und idempotenter Wiederholung absichern.
turnComplete,IN_PROGRESS,IDLE, Unterbrechung und Verbindungsabbruch getrennt testen.- Video nur senden, wenn es für die Aufgabe nötig ist: 3.8 Live bezieht Videoframes standardmäßig in die Turn-Abdeckung ein.
- Altes und neues Modell mit identischen deutschsprachigen Testgesprächen vergleichen; nicht nur gefühlte Natürlichkeit, sondern Ergebnis und Risiko messen.
Kosten: günstig pro Audiominute, aber nicht pro gelöstem Fall
Die öffentliche Gemini-API-Preisliste nennt für Gemini 3.8 Live und Extended Thinking im Standardtarif 0,75 US-Dollar je Million Texteingabetoken, 3 US-Dollar je Million Audioeingabetoken beziehungsweise rund 0,005 Dollar je Audiominute. Audioausgabe kostet 12 Dollar je Million Token beziehungsweise rund 0,018 Dollar je Minute. Bild und Video werden separat berechnet; Textausgabe einschließlich Thinking-Tokens kostet 4,50 Dollar je Million Token.
| Illustratives Monatsvolumen | Annahme | Reine Audiokosten |
|---|---|---|
| 1.000 Gesprächsminuten | 50 % Nutzer-, 50 % Modellsprache | ca. 11,50 US-Dollar |
| 10.000 Gesprächsminuten | 50 % Nutzer-, 50 % Modellsprache | ca. 115 US-Dollar |
| 100.000 Gesprächsminuten | 50 % Nutzer-, 50 % Modellsprache | ca. 1.150 US-Dollar |
Illustrative Modellrechnung: Gesprächszeit gleichmäßig auf Audioeingabe und Audioausgabe verteilt. Nicht enthalten sind Text-, Bild- und Videotoken, Suchabfragen, Telefonie, Plattformkosten, erneute Kontextverarbeitung, Tool-Systeme, Monitoring, Integration und menschliche Bearbeitung.
Der Modellpreis kann deshalb leicht in die Irre führen. Extended Thinking kann einen Fall in weniger Übergaben lösen – oder durch längeres Reasoning, mehr Tool-Runden und zusätzliche Prüfungen höhere Gesamtkosten verursachen. Die belastbare Kennzahl lautet nicht „Dollar pro Minute“, sondern Kosten pro korrekt gelöstem oder korrekt übergebenem Anliegen.
Gemini 3.8 Live im Wettbewerb
Ein belastbarer Vergleich muss zuerst klären, welche Ebene beschafft wird. Gemini 3.8 Live, OpenAIs GPT-Live-1 und Amazon Nova 2 Sonic sind Sprachmodelle beziehungsweise Sprachschichten. Azure Voice Live ist dagegen eine verwaltete Orchestrierungs-API, die Sprachdienste, Modelle und optionale Komponenten wie eigene Stimmen oder Avatare bündelt. Minutenpreise sind deshalb nicht ohne Weiteres vergleichbar.
Gemini 3.8 Live
Laut Google-Modellseite bietet es native Audioausgabe, multimodale Eingaben einschließlich Bild und Video sowie die Wahl zwischen niedriger Latenz und einer separaten Extended-Thinking-Variante.
Passt besonders: wenn Gemini bereits im Stack liegt und Kamera-, Bildschirm- oder komplexere Tool-Szenarien wichtig sind.
GPT-Live-1
OpenAI beschreibt GPT-Live-1 als Vollduplex-Sprachschicht mit Backend-Delegation. Der Listenpreis beträgt 0,05 US-Dollar pro Minute für die Sprachschicht; Backend-Modell und Werkzeuge kommen hinzu. Laut Modelldokumentation unterstützt es keine Bild- oder Videoeingaben.
Passt besonders: wenn natürliche Unterbrechungen und eine flexible Trennung von Sprachschicht und Backend-Agent im Vordergrund stehen.
Azure Voice Live
Die verwaltete Plattformschicht bündelt Azure Speech, auswählbare GPT-, Azure- oder Phi-Modelle und optionale Custom-Voice- beziehungsweise Avatar-Dienste. Abrechnung und Fähigkeiten hängen von der gewählten Kombination ab.
Passt besonders: für Azure-lastige Unternehmen, die Entra-Identitäten, Foundry-Integration und weniger Eigenbau priorisieren.
Amazon Nova 2 Sonic
AWS nennt für Nova 2 Sonic Speech-to-Speech, asynchrone Tool-Aufrufe, ein Kontextfenster mit einer Million Token und Amazon-Connect-Integration. Verfügbar ist das Modell derzeit in zwei US-Regionen und Tokio.
Passt besonders: für AWS- und Amazon-Connect-Umgebungen; die fehlende EU-Region ist für DACH-Projekte ein früher Prüfpunkt.
Preisbild der Wettbewerber
Die Listenpreise messen nicht dasselbe. Deshalb zeigt der Vergleich, welcher Kostenbaustein jeweils enthalten ist. Telefonie, Carrier, Tool-Aufrufe, Datenbanken, Monitoring und menschliche Übergaben sind bei allen Varianten zusätzlich zu kalkulieren.
Gemini 3.8 Live
0,005 $/Min. Eingabe
0,018 $/Min. Ausgabe
Bei 50/50-Sprechanteil rechnerisch rund 0,0115 $ je Gesprächsminute. Text, Bild, Video und Suche können hinzukommen.
GPT-Live-1
0,05 $ je Sitzungsminute
Enthält die Frontend-Sprachschicht und wird sekundengenau abgerechnet. Backend-Modell und Werkzeuge werden separat berechnet.
Azure Voice Live
Kein einheitlicher Minutenpreis
Tokenbasierte Pro-, Basic- und Lite-Tarife hängen vom gewählten Modell und der Audioart ab. Custom Speech, Custom Voice und Avatare können zusätzlich berechnet werden; der konkrete Betrag ist regionsbezogen im Azure-Rechner zu ermitteln.
Amazon Nova 2 Sonic
ca. 0,27 $ je Stunde Eingabeaudio
Das entspricht rund 0,0045 $ je Eingabeminute. Der von AWS genannte Wert ist kein vollständiger Gesprächspreis; Ausgabe, Textkontext, Tools, Telefonie und Infrastruktur müssen separat berücksichtigt werden.
Preisstand: 16. September 2026, öffentliche Herstellerangaben, ohne Rabatte und Steuern. Die Werte sind wegen unterschiedlicher Abrechnungsobjekte nicht als direkte Rangliste zu lesen. Für eine Ausschreibung sollte jedes Angebot auf denselben Gesprächsmix, dieselben Tool-Aufrufe und dieselbe Telefoniearchitektur normalisiert werden.
Beschaffungsregel: Zuerst Cloud- und Contact-Center-Anbindung, Datenregion, Telefonie, multimodale Anforderungen und gewünschte Eigenkontrolle festlegen. Danach alle Kandidaten mit demselben deutschsprachigen Testkorpus und identischen Werkzeugen prüfen. Entscheidend sind Lösungsquote, korrekte Übergabe, P95-Latenz und Gesamtkosten je Fall – nicht die Demo-Stimme.
Praxisbeispiel: Störungsannahme im technischen Service
Das folgende Szenario ist hypothetisch und dient als Planungsmodell. Ein Maschinenbauer möchte die telefonische Störungsannahme außerhalb der Kernzeiten verbessern. Gemini 3.8 Live erfasst Maschine, Standort, Fehlercode und Rückrufnummer. Für bekannte Fehlerbilder liest ein begrenztes Werkzeug freigegebene Hinweise aus. Sicherheitskritische Meldungen, unklare Identität und Eingriffe in Maschinensteuerungen werden sofort an den Bereitschaftsdienst übergeben.
Extended Thinking kommt erst in einer zweiten Pilotstufe zum Einsatz. Es darf mehrere interne Wissensquellen vergleichen und währenddessen einen gesprochenen Zwischenstand liefern. Das Modell erhält keine Schreibrechte im ERP und darf keinen Wartungsauftrag selbst freigeben. Ein separater Dienst erzeugt nach expliziter Bestätigung einen Entwurf; die Disposition übernimmt oder verwirft ihn.
Messbare Pilotfrage: Reduziert die neue Sprachschicht Abbrüche, Rückfragen und Bearbeitungszeit, ohne Fehlklassifikationen, Doppelaufträge oder riskante Handlungsempfehlungen zu erhöhen? Gemessen werden Lösungsquote, korrekte Übergabe, P95-Latenz, Kosten je Fall, Abbruchquote und sicherheitskritische Fehlaktionen.
DACH-Governance: Sprache ist Prozess- und Personendatum
Audioaufnahmen, Transkripte, Stimmmerkmale, Gesprächsinhalte, Tool-Aufrufe und CRM-Daten bilden gemeinsam einen sensiblen Datenfluss. Für Unternehmen genügt deshalb kein allgemeiner Verweis auf eine verfügbare Google-Cloud-Region. Der konkrete Dienst, Vertragsweg, Speicherort, Verarbeitungsort, Logging-Umfang und die jeweils aktivierten Werkzeuge müssen dokumentiert werden.
Kontrollen vor dem Produktivbetrieb
- Transparenz: Gesprächspartner früh und verständlich über den KI-Einsatz informieren.
- Rechtsgrundlage und Löschung: Zwecke, Aufbewahrungsfristen und Zugriffe für Audio, Transkript und Protokolle festlegen.
- Authentifizierung: Stimme nicht als alleinigen Identitätsnachweis verwenden; sensible Vorgänge separat absichern.
- Least Privilege: Tools, Datenfelder, Beträge, Ziele und Häufigkeit außerhalb des Modells begrenzen.
- Unterbrechung und Not-Aus: Ein abgebrochener Dialog muss laufende Hintergrundaktionen kontrolliert stoppen oder sicher zu Ende führen.
- Menschliche Übergabe: Beschwerden, Unsicherheit, Hochrisikoentscheidungen und irreversible Aktionen an zuständige Personen übergeben.
- Nachweisbarkeit: Modellversion, Prompt, Tool-Aufruf, Ergebnis, Freigabe und Fehlerzustand revisionsfähig protokollieren.
Für Browser- oder Mobilanwendungen empfiehlt Google kurzlebige, auf eine Sitzung und Konfiguration begrenzbare Tokens. Das reduziert das Risiko offengelegter langlebiger API-Schlüssel, ersetzt aber keine sichere Backend-Authentifizierung. Die Dokumentation nennt standardmäßig eine Minute zum Start einer Sitzung und 30 Minuten Nutzungsdauer; für längere Verbindungen bleibt ein kontrollierter Wiederanlauf nötig.
Was die Modellkarte belegt – und was offenbleibt
Die Modellkarte zu Gemini 3.8 Audio beschreibt beide Varianten als auf Gemini 3 Pro basierende, nativ multimodale Modelle. Google nennt Halluzinationen, gelegentliche Verzögerungen und Timeouts als bekannte Grenzen; der Wissensstand wird mit Januar 2025 angegeben.
Für die Frontier-Sicherheitsbewertung verweist Google auf Ergebnisse von Gemini 3.7 Flash und erklärt, 3.8 Live bringe keine wesentliche neue Fähigkeitsstufe. Das ist eine Herstellerbewertung, keine unabhängige Prüfung deutschsprachiger Contact-Center-, Gesundheits-, Finanz- oder Industrieszenarien. Unmittelbar nach der Veröffentlichung fehlen zudem belastbare öffentliche Vergleichstests zu Dialekten, Sprecherwechseln, schlechten Leitungen, Störgeräuschen, Fachbegriffen und langen Werkzeugketten.
Evidenzgrenze: GA-Status bedeutet eine stabile Modell-ID und einen regulären Produktweg. Er beweist weder die Eignung für einen konkreten Geschäftsprozess noch eine bestimmte Datenresidenz, Sprachqualität oder Lösungsquote. Diese Punkte müssen Unternehmen im eigenen Zielsystem testen.
Entscheidungsmatrix: Welcher Weg passt?
| Entscheidung | Wann sie passt |
|---|---|
| Gemini 3.8 Live pilotieren | Direkte Dialoge, schnelle Tools, klare Gesprächsgrenzen und reversible Aktionen. |
| Extended Thinking testen | Mehrstufige Recherche oder langsame Werkzeuge erzeugen belegbaren Nutzen und die Anwendung beherrscht asynchrone Zustände. |
| Klassische STT–LLM–TTS-Kette behalten | Transkription, Fachlogik und Stimme müssen separat austauschbar, prüfbar oder regional betreibbar bleiben. |
| Mitbewerber-Pilot durchführen | Cloud-Stack, Contact Center, Datenregion oder Betriebsmodell wiegen stärker als einzelne Modellfunktionen. |
| Produktivfreigabe verschieben | Datenfluss, Tool-Rechte, Abbruchlogik, menschliche Übergabe oder Messkriterien sind ungeklärt. |
Fazit: Sprachqualität ist nur die Oberfläche
Gemini 3.8 Live und Extended Thinking verschieben die Live API von einem reinen Echtzeitdialog hin zu zwei klareren Betriebsmodellen: schnelle Gesprächsführung oder dialogfähiges Hintergrund-Reasoning. Gerade diese Wahl macht die Veröffentlichung für Unternehmen relevant.
Der richtige nächste Schritt ist kein flächiger Austausch des bisherigen Voice-Stacks. Er ist ein kontrollierter Vergleich auf einem häufigen, reversiblen Gesprächspfad. Erst wenn Ergebnisqualität, Latenz, Gesamtkosten, Datenfluss und Fehlverhalten gemeinsam besser ausfallen, sollte die neue Modellfamilie mehr Rechte oder größere Prozessanteile erhalten.
FAQ zu Gemini 3.8 Live
Sind Gemini 3.8 Live und Extended Thinking allgemein verfügbar?
Ja. Google führt beide Modell-IDs seit dem 15. September 2026 als stabile GA-Modelle. Der konkrete Zugang, Vertragsweg und die regionale Verfügbarkeit sind je Dienst und Konto zu prüfen.
Ist Extended Thinking immer leistungsfähiger?
Nicht für jeden Prozess. Es ist für komplexe, mehrstufige Aufgaben gedacht, erhöht aber Zustands-, Test- und Governance-Aufwand. Für direkte Servicefragen ist Gemini 3.8 Live meist der passendere Ausgangspunkt.
Kann das Modell direkt im Browser eingesetzt werden?
Die Live API unterstützt clientseitige Verbindungen. Google stellt dafür kurzlebige Tokens bereit, die auf eine Sitzung und Konfiguration begrenzt werden können. Ein dauerhafter API-Schlüssel gehört nicht in Browser- oder App-Code.
Ersetzt Gemini 3.8 Live eine Voice-Agent-Plattform?
Nein. Das Modell liefert den Echtzeit-Sprach- und Reasoning-Kern. Telefonie, CRM-Integration, Identitätsprüfung, Rechte, Monitoring, Qualitätsmanagement und menschliche Übergabe müssen separat gelöst werden.
Weiterführende Artikel auf AI-Fabrik
- GPT-Live-1 für Voice-Agenten: Architektur, Kosten und Governance
- Realtime Audio APIs und Sprachmodelle im Unternehmensvergleich
- Gemini 3.8 Flash und Flash Cyber: Enterprise-Check
- KI-Agenten-Governance: Rollen, Rechte und Kontrollen
Quellen
- Google AI for Developers: Gemini API Release Notes, 15. September 2026
- Google AI for Developers: Gemini 3.8 Live – Modelldaten und Migration, Stand 15. September 2026
- Google AI for Developers: Gemini 3.8 Live Extended Thinking – Modelldaten, Stand 15. September 2026
- Google AI for Developers: Thinking in the Live API, abgerufen am 16. September 2026
- Google AI for Developers: Live API capabilities guide, abgerufen am 16. September 2026
- Google AI for Developers: Gemini Developer API pricing, abgerufen am 16. September 2026
- Google AI for Developers: Gemini deprecations, abgerufen am 16. September 2026
- Google DeepMind: Gemini 3.8 Audio Model Card, 15. September 2026
- Google AI for Developers: Ephemeral Tokens für die Live API, abgerufen am 16. September 2026
- OpenAI: Introducing GPT-Live-1 in the API, 10. September 2026
- OpenAI Developers: GPT-Live-1 – Modelldaten, abgerufen am 16. September 2026
- Microsoft Learn: Azure Voice Live overview, abgerufen am 16. September 2026
- Microsoft Azure: Azure Speech und Voice Live – Preise, abgerufen am 16. September 2026
- AWS: Amazon Nova 2 Sonic for real-time conversational AI, abgerufen am 16. September 2026
- AWS Machine Learning Blog: Nova 2 Sonic – Praxis- und Kostenangabe, 24. Juni 2026