Redaktionshinweis: KI-gestützter Entwurf auf Basis der unten verlinkten Quellen. Menschliche Schlussprüfung ausstehend; kein eigener Modell- oder Hardwaretest. Produkt- und Leistungsangaben stammen überwiegend von NVIDIA. Stand: 15. Oktober 2026 · Version 1.0.
In 30 Sekunden
- NVIDIA erweitert Nemotron 3.5 um Super VL und Bolt 74B. Beide sind laut Ankündigung verfügbar; Bolt E4B soll am 23. Oktober folgen.
- Super VL adressiert multimodale Agenten, Bolt den lokalen Einsatz. Lightning wurde bereits im August vorgestellt.
- Beworbene Beschleunigungen sind an konkrete Modelle, Hardware und Testbedingungen gebunden.
- Für DACH-Unternehmen zählt, ob ein abgegrenzter Prozess mit eigenen Daten zuverlässig und wirtschaftlich läuft.
Für wen? Für IT-Leitungen und KI-Verantwortliche, die eigene Agenten betreiben oder einen bestehenden API-basierten Workflow ergänzen wollen.
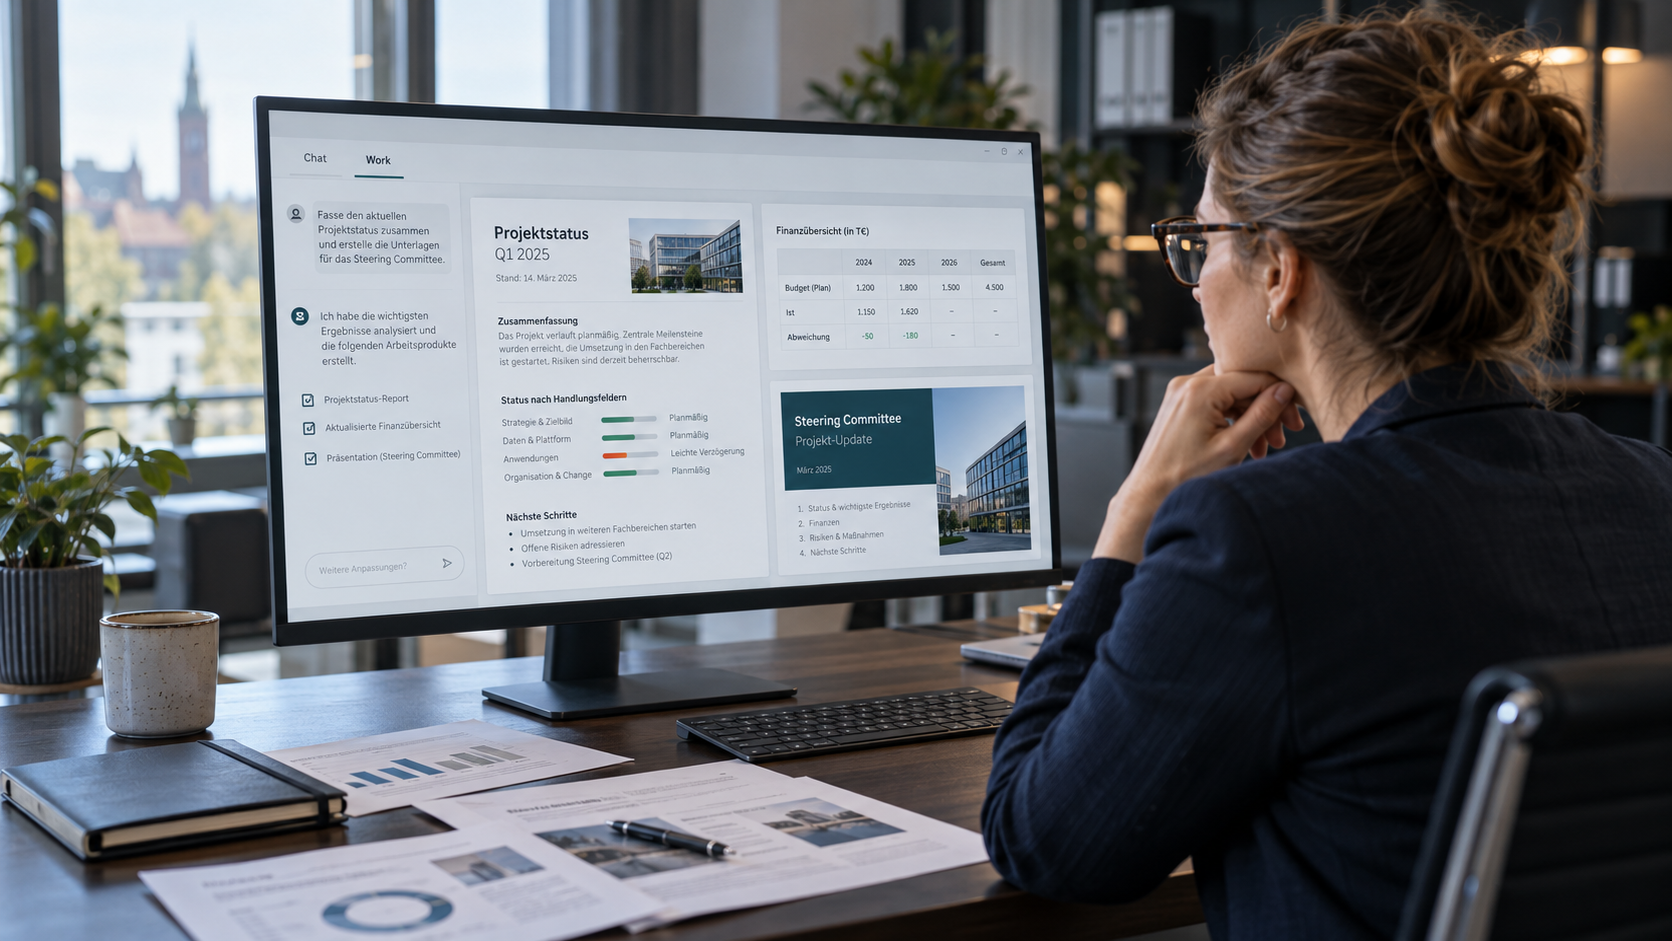
Ein Agent liest eine Rechnung, gleicht sie mit einer Bestellung ab und bereitet einen Buchungsvorschlag vor. Die Modellantwort ist dabei nur ein Teil der Arbeit: Dokumentenzugriff, Werkzeugrechte, Fehlerbehandlung und Freigaben entscheiden darüber, ob der Vorgang tatsächlich entlastet. Genau an dieser Schnittstelle wird NVIDIAs neue Modellgeneration interessant. Sie erweitert die Auswahl für eigene Systeme – und stellt IT-Leitungen vor eine konkrete Betriebsentscheidung.
Unsere Empfehlung: Einen Prozess vor der Hardware auswählen
Benennen Sie einen fachlichen Verantwortlichen und wählen Sie einen wiederkehrenden, zunächst nur lesenden Dokumentenprozess. Vergleichen Sie Nemotron mit Ihrer bestehenden Lösung an denselben freigegebenen Fällen. Entscheiden Sie über Hardware erst nach der Messung von Ergebnisqualität, Bearbeitungszeit und Vollkosten je akzeptiertem Vorgang.
Was NVIDIA mit Nemotron 3.5 veröffentlicht
Die Ankündigung vom 15. Oktober ergänzt die Familie um unterschiedliche Einsatzgrößen. Die Übersicht trennt den aktuellen Herstellerstatus von der redaktionellen Einsatzbewertung.
| Modell | Status laut NVIDIA | Wofür prüfen? |
|---|---|---|
| Nemotron 3.5 Super VL | Verfügbar | Agenten, die Text und visuelle Dokumentinhalte gemeinsam auswerten. |
| Bolt 74B-A9B 24GB | Verfügbar; native 2-Bit-Quantisierung | Lokale Agenten auf geeigneter NVIDIA-Hardware. |
| Bolt E4B 4GB | Für 23. Oktober 2026 angekündigt | Als spätere Option für kompakte Gesprächsanwendungen vormerken. |
| Nemotron 3.5 Lightning | Bereits am 11. August vorgestellt | Spezialisierte Textaufgaben mit hohem Durchsatz. |
Lightning ist also keine heutige Neuveröffentlichung. NVIDIA beschreibt es als Mixture-of-Experts-Modell mit 30 Milliarden Gesamtparametern und drei Milliarden aktiven Parametern. Die technische Einführung nennt Anpassung und effiziente Inferenz als Schwerpunkte.
Warum Super VL für Dokumentenprozesse interessant ist
Laut technischem NVIDIA-Blog kombiniert Super VL Werkzeugnutzung und Schlussfolgern mit Text-, Bild-, Dokument- und Videoverständnis. NVIDIA nennt eine MoE-Architektur mit 120 Milliarden Gesamtparametern und zwölf Milliarden aktiven Parametern je Token.
Die geringe Zahl aktiver Parameter bedeutet nicht, dass nur dieser Teil als Speicherbedarf einzuplanen wäre. Für eine Beschaffung müssen Modellgewichte, Präzision, Kontextspeicher, Laufzeit und gleichzeitige Anfragen zusammen betrachtet werden. Auch ein Modell, das in den Speicher passt, muss noch genügend Reserven für den gewünschten Betrieb besitzen.
Redaktionelle Einordnung: Ein gemeinsames Modell für Text und Bilder kann Übergaben zwischen getrennten Verarbeitungsschritten reduzieren. Ob es in einem konkreten Prozess besser funktioniert als eine spezialisierte Dokumentenerkennung plus Sprachmodell, bleibt eine Testfrage. Bei schlecht gescannten Tabellen, ungewöhnlichen Belegen oder deutschen Fachbegriffen kann gerade diese Unterscheidung über den Nutzen entscheiden.
Was die Geschwindigkeitsversprechen tatsächlich aussagen
NVIDIA bewirbt bis zu fünffachen Durchsatz. Die technische Darstellung vergleicht unter anderem die Ausgabegeschwindigkeit mit Inkling Small bei 100.000 Eingabetokens und verweist auf einen Baseten-Endpunkt. Ein weiterer Herstellervergleich mit Dynamo nennt bis zu achtmal so viele Nutzer und 85 Prozent geringere Zeit bis zum ersten Token – auf 16 B200-GPUs bei 50 Tokens pro Sekunde und Nutzer. Das sind unterschiedliche Messungen.
Evidenzgrenze
Diese Werte sind kein Nachweis für fünfmal schnellere Geschäftsprozesse oder entsprechend niedrigere Gesamtkosten. Die Redaktion hat sie nicht reproduziert. Vergleichskonfiguration, Auslastung, Kontextlänge und Fehlerquote müssen zum eigenen Einsatz passen.
Ein Agent wartet auch auf Datenbanken, externe Werkzeuge und fachliche Entscheidungen. Eine hohe Tokenrate hilft wenig, wenn er häufiger nacharbeiten muss oder falsche Werkzeugaufrufe erzeugt. Messen Sie deshalb die Zeit bis zum fachlich akzeptierten Ergebnis einschließlich Wiederholungen und menschlicher Korrektur.
Offene Modelle: Mehr Gestaltungsspielraum, zusätzliche Betriebsarbeit
NVIDIA stellt offene Gewichte und Anpassungsmöglichkeiten in den Mittelpunkt. Der technische Beitrag nennt außerdem Trainingsrezepte, Daten und Lernumgebungen. Für Super VL werden unter anderem Hugging Face und NIM als Zugangswege genannt. NIM bündelt Inferenzsoftware; Enterprise-Support verweist NVIDIA auf AI Enterprise.
Offener Prüfpunkt: Die neuen Hugging-Face-Modellkarten konnten bei dieser Recherche nicht zuverlässig gelesen werden. Der Artikel bestätigt daher keine abschließenden Lizenzrechte für sämtliche Checkpoints und Begleitkomponenten. Vor dem Einsatz sind die konkrete Modellversion, ihre Lizenzdatei, Weitergabebedingungen und die Bedingungen des gewählten Serving-Angebots zu dokumentieren.
Offene Gewichte schaffen eine Wechseloption beim Modellbetrieb. Die tatsächliche Portabilität hängt zusätzlich von Quantisierung, Inferenzsoftware und Hardware ab. Wer ausschließlich auf einen optimierten GPU-Stack setzt, sollte den Aufwand eines späteren Wechsels ebenso bewerten wie die heutige Geschwindigkeit. Die Dynamo-Rezepte zeigen dafür unterschiedliche GPU- und Serving-Konfigurationen; es handelt sich ausdrücklich um die Entwicklungsdokumentation.
Hypothetisches Praxisbeispiel: Rechnungsprüfung im Mittelstand
Ein mittelständischer Maschinenbauer möchte eingehende Rechnungen mit Bestellungen abgleichen. Dieses Beispiel ist eine redaktionelle Illustration, kein dokumentierter Nemotron-Kundentest. Das Modell soll Positionen und Beträge aus Dokumenten erfassen, Abweichungen erklären und einen prüfbaren Vorschlag erzeugen. Der Bestellzugriff erfolgt über eine begrenzte, nur lesende Schnittstelle.
Super VL wäre hier ein Kandidat für die gemeinsame visuelle und sprachliche Verarbeitung. Eine lokale Variante wäre dann interessant, wenn die nötige Qualität auf vorhandener Hardware erreicht wird und Datenflüsse dadurch einfacher kontrollierbar werden. Beide Annahmen muss der Pilot erst bestätigen.
Der Fachbereich stellt beispielsweise 50 freigegebene Testfälle zusammen: saubere Belege, schwierige Scans, Gutschriften, fehlende Bestellnummern und widersprüchliche Summen. Diese Anzahl ist ein illustrativer Pilotumfang, keine statistische Qualitätsgarantie. Für jeden Fall werden die erwarteten Felder und erlaubten Folgeaktionen vorab festgelegt. Belege ohne eindeutige Zuordnung müssen zur Klärung gehen.
Firmenspezifisches Wissen kann zunächst über einen kontrollierten Dokumentenzugriff ergänzt werden. Dafür bietet der Vergleich von RAG-Systemen eine Entscheidungshilfe. Ein aufwendiges Nachtraining sollte erst folgen, wenn klar ist, welche verbleibenden Fehler es beheben soll.
Governance: Der Agent braucht Grenzen außerhalb des Modells
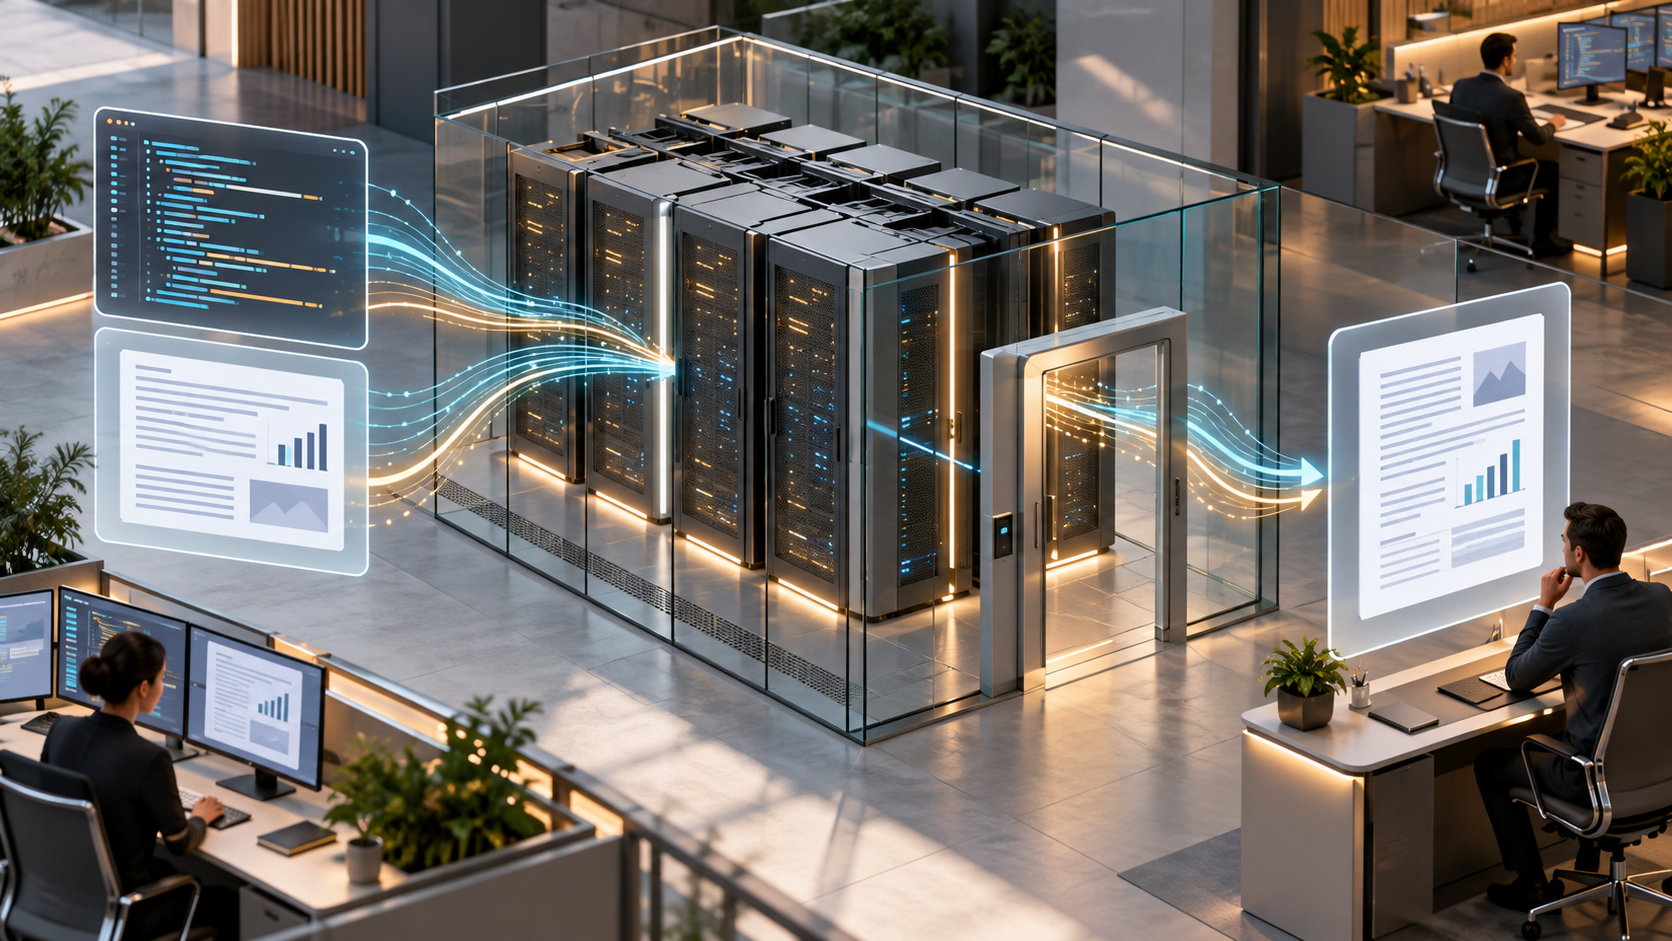
Externe Dokumente sind zugleich eine mögliche Angriffsquelle. OWASP beschreibt Prompt Injection auch über eingebettete Anweisungen in Dateien und Bildern. Ein Rechnungsbeleg darf deshalb keine neue Werkzeugberechtigung oder einen zusätzlichen Empfänger festlegen.
Kontrolle für den Pilot
Beschränken Sie Dokumentenquellen und Werkzeugzugriffe technisch. Buchungen, Zahlungen und externe Nachrichten bleiben zunächst gesperrt. Eine spätere Freigabe muss Aktion, Ziel und betroffene Daten anzeigen; sie erfolgt außerhalb des vom Agenten bearbeiteten Kontexts. Fachliche Freigaben ergänzen die technischen Grenzen.
Testen Sie vor dem Start und nach Änderungen an Modell, Prompt oder Werkzeugrechten gezielt manipulierte Belege, unerlaubte Empfänger und doppelte Ausführungsversuche. Als Abnahmekriterium empfehlen wir: keine nicht autorisierten Aktionen in diesen Tests, nachvollziehbare Protokolle und ein funktionierender Stopp. Die IT verantwortet technische Befunde, der Prozessverantwortliche die fachliche Fehlerbewertung. Ein bestandener Test ist keine allgemeine Sicherheitsgarantie.
Für einen kleinen, nur lesenden Pilot genügen ein benannter Verantwortlicher, begrenzte Datenbestände und ein wiederholbarer Testplan. Bei produktiven Finanzaktionen sind stärkere Überwachung, getrennte Rollen und ein geregelter Vorfallprozess angemessen.
DACH-Prüfauftrag: Klären Sie mit Datenschutz und gegebenenfalls Arbeitnehmervertretung die verwendeten Daten, Aufbewahrung der Protokolle, Berechtigungen und mögliche Beschäftigtenauswertungen. Beim Hosting kommen Vertragspartner, Verarbeitungsort und externe Dienste hinzu. Lokale Inferenz allein beantwortet diese Fragen nicht: Werkzeuge, Telemetrie und Backups können weiterhin Daten übertragen. Die anwendungsbezogene rechtliche Prüfung bleibt separat.
Kostenvergleich: Der akzeptierte Vorgang ist die richtige Einheit
Für diese Recherche liegt kein belastbarer, einheitlicher Preis für den gewünschten produktiven Nemotron-Betrieb vor. Ein kostenloser Download ersetzt keine Vollkostenrechnung. Vergleichen Sie für denselben Zeitraum Hardware oder Hosting, Energie, Software und Support, Integration, Betrieb sowie Nacharbeit.
Pilotformel: Vollkosten je akzeptiertem Vorgang = anteilige Infrastruktur-, Software-, Betriebs- und Prüfkosten ÷ fachlich akzeptierte Vorgänge.
Diese Formel ist eine redaktionelle Kalkulationshilfe. Zeitersparnis wird separat bewertet, damit Personalkosten nicht doppelt gezählt werden. Bei geringer Auslastung kann ein verwalteter Dienst trotz höherem Nutzungspreis wirtschaftlicher sein. Bei regelmäßigem Volumen und vorhandenem Betriebsteam kann eigene Infrastruktur attraktiver werden. Der Modellname entscheidet das nicht.
Fazit: Ein guter Kandidat für einen begrenzten Vergleich
Nemotron 3.5 erweitert die Optionen für Unternehmen, die Modelle selbst anpassen und betreiben wollen. Die nächste sinnvolle Entscheidung ist ein Vergleich an einem konkreten Prozess mit festgelegter Abnahme. Besteht das Modell diesen Test, lohnt die Planung des Betriebs. Scheitert es an Dokumentenqualität oder Werkzeugzuverlässigkeit, behebt ein schnellerer Server das Problem nicht.
FAQ
Ist Nemotron ein fertiger Unternehmensagent?
Nein. Das Modell ist eine Komponente. Datenzugriff, Ablaufsteuerung, Werkzeuge, Rechte und Überwachung müssen als Anwendung ergänzt werden.
Garantiert „24GB“ im Bolt-Namen den Betrieb auf jeder 24-GB-GPU?
Nein. NVIDIA nennt eine entsprechend optimierte Variante. Die tatsächliche Eignung hängt zusätzlich von unterstützter Hardware, Laufzeit, Kontext und konkurrierender Speichernutzung ab.
Muss ein Unternehmen sofort nachtrainieren?
Unsere Empfehlung ist, zuerst unverändert mit klaren Aufgaben, zugelassenen Werkzeugen und geeigneten Dokumenten zu testen. Nachtraining ist erst sinnvoll, wenn konkrete, wiederkehrende Qualitätslücken und geeignete Trainingsdaten vorliegen.
Warum nennt der Artikel keine verbindliche Betriebskostenersparnis?
Ohne Messung des eigenen Workflows fehlen Auslastung, Fehlerkosten und Betriebsaufwand. Herstellerwerte zur Inferenz lassen sich nicht direkt in eine Unternehmensrendite übersetzen.
Quellen
Quellenstand: 15. Oktober 2026. NVIDIA-Quellen sind Herstellerquellen; ein eigener Leistungsnachweis liegt nicht vor.
- NVIDIA, 15.10.2026: Ankündigung von Super VL und Bolt.
- NVIDIA Technical Blog, 15.10.2026: Super VL: Architektur, Anpassung und Benchmarks.
- NVIDIA Technical Blog, 11.08.2026: Nemotron 3.5 Lightning.
- NVIDIA, Entwicklungsdokumentation, abgerufen am 15.10.2026: Dynamo-Deployment-Rezepte für Super VL.
- OWASP, LLM Top 10 2025: LLM01: Prompt Injection.
Weiterführende Artikel auf AI-Fabrik
- Perplexity Portable Computer: Welche Betriebsfragen lokale Agenten aufwerfen.
- RAG-Systeme im Vergleich: Wie freigegebenes Unternehmenswissen angebunden wird.
- NVIDIA NemoClaw für Unternehmen: Architekturhintergrund aus März 2026; damaligen Produktstatus beachten.